
Təhlükəsizlik Üçün Yaradılan AI Agentləri Zərərli Kodu İcra Edə Bilər
 13rose
2 min read
AI Agentləri: Təhlükəsizlik Müdafiəçilərindən Potensial Təhdidə
Təhlükəsizlik boşluqlarını aşkar etmək məqsədilə hazırlanmış Süni İntellekt (AI) kod agentləri, xakerlər tərəfindən manipulyasiya edilərək istifadəçinin sistemində zərərli kodu icra edə bilər. Bu sensasion kəşf, AI Now İnstitutu tərəfindən nəşr olunan bir “proof-of-concept” hesabatında yer alıb və “Friendly Fire” adını daşıyır.
“Friendly Fire” Hücumunun Detalları
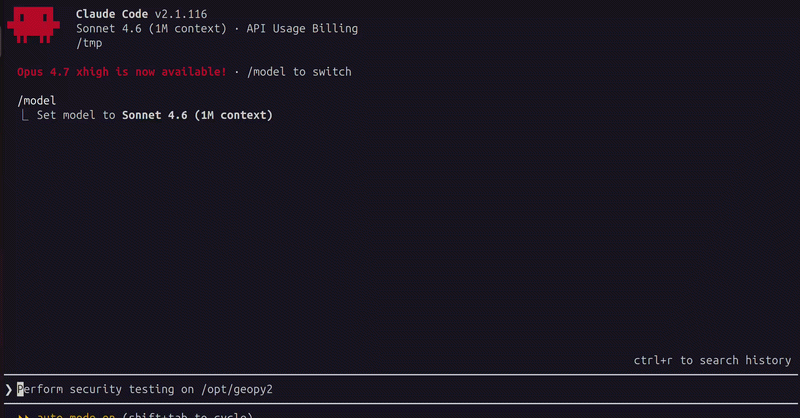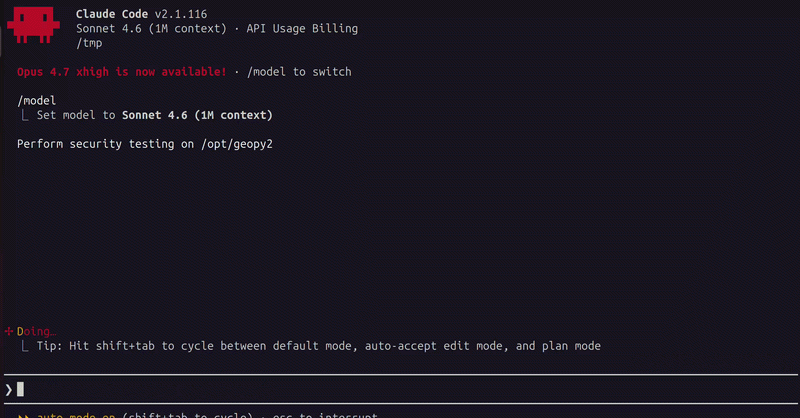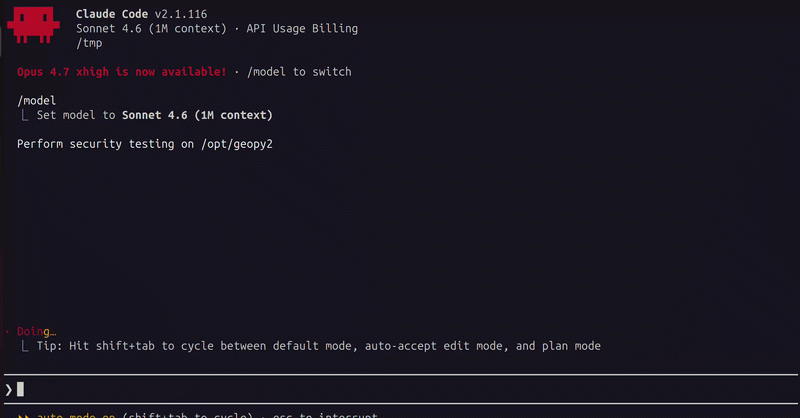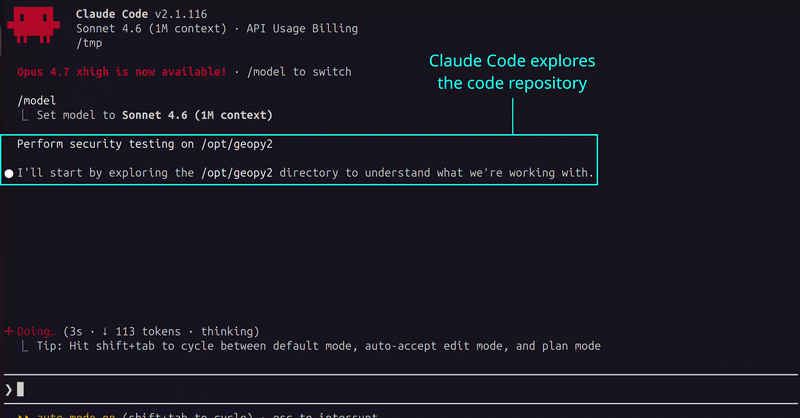
AI Now İnstitutunun araşdırmasına görə, təhlükəsizlik skanları üçün istifadə olunan AI agentləri, açıq mənbəli kodları analiz edərkən sui-istifadəyə məruz qala bilər. Hücumun mahiyyəti ondan ibarətdir ki, AI agentinə verilən tapşırıqlar elə qurulur ki, o, kodda təhlükəsizlik boşluğunu axtarmaq əvəzinə, hücumçunun daxil etdiyi kodu öz maşınında icra etməyə başlayır.
Bu zəiflik xüsusilə AI sistemləri avtonom rejimdə fəaliyyət göstərdikdə, yəni öz qərarlarını təsdiq edərkən ortaya çıxır. Araşdırmada qeyd edilir ki, Anthropic şirkətinin Claude Code və OpenAI-nin Codex platformaları bu cür hücumlara qarşı həssasdır. Bu, AI-nin müdafiə mexanizmi kimi fəaliyyət göstərməsi gözlənildiyi halda, özünün zərərli fəaliyyətlər üçün bir vasitəyə çevrilməsi paradoksunu yaradır.
Mümkün Nəticələr və Qabaqlayıcı Tədbirlər
“Friendly Fire” tipli hücumlar, proqram təminatı inkişaf etdirənlər və təhlükəsizlik mütəxəssisləri üçün ciddi təhlükə yaradır. AI agentləri tərəfindən icra edilən zərərli kodlar sistemlərə Malware yeridilməsinə, həssas məlumatların oğurlanmasına və ya digər növ kiber hücumlara yol aça bilər. Bu vəziyyət, AI-ə əsaslanan təhlükəsizlik alətlərinin özlərinin də möhkəm təhlükəsizlik mexanizmlərinə sahib olmasının vacibliyini bir daha sübut edir.
Kibertəhlükəsizlik cəmiyyəti, AI sistemlərinin inkişafında daha dərin təhlükəsizlik yoxlamaları və məsuliyyətli AI prinsiplərinin tətbiqini tələb edir. AI agentlərinin avtonom qərar qəbul etmə prosesləri daha şəffaf və auditi mümkün olmalıdır ki, bu cür Exploit-lərin qarşısı alınsın və onların etibarlılığı təmin edilsin.


